정규화 용어 정리
10월 22, 2025· ·
2 분 읽기
안상아
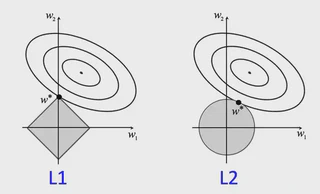 Image credit: Unsplash
1. Normalization (Min-Max Scaling)
- 각 속성의 최소·최댓값을 이용해 데이터를 0~1 범위로 선형 변환.
- 특징:
- 분포가 비교적 고르고 극단값(outlier)이 적은 경우 효과적.
- 모델에 따라 입력 스케일이 민감한 경우(신경망, 거리 기반 알고리즘 등) 학습 안정성 향상.
- 최소·최댓값이 변경되면 다시 스케일링해야 하므로 온디맨드 재계산 필요.
- 수식:
$$x’ = \frac{x - x_{\min}}{x_{\max} - x_{\min}}$$
2. Standardization (Z-score Scaling)
- 데이터의 평균을 0, 표준편차를 1로 맞춰 정규화.
- 특징:
- 평균과 분산을 기준으로 하므로 정규분포에 가까운 데이터에서 안정적.
- outlier의 영향을 상대적으로 덜 받으며, 학습된 파라미터(평균·표준편차)를 이용해 새로운 데이터 스케일링 가능.
- 가장 일반적으로 사용되는 스케일링 기법.
- 수식:
$$z = \frac{x - \mu}{\sigma}$$
Normalization과 Standardization은 모두 데이터 전처리(Data Preprocessing) 단계에서 수행되어 모델 학습이 더 빨리, 안정적으로 수렴하도록 돕는다.
3. Regularization
- 목적: Overfitting(과적합) 방지.
- 과적합 = 모델이 훈련 데이터에 과도하게 적응하여 새로운 데이터 일반화 실패.
- 특징:
- 데이터 전처리가 아니라 모델 학습(Learning) 단계에서 가중치에 패널티를 부여.
- L1, L2, Elastic Net, Dropout 등 다양한 형태가 존재.
- 모델의 복잡도를 제어해 Generalization(일반화) 성능 향상을 직접 목표로 한다.
4. Generalization
- 정의: 모델이 훈련에 사용되지 않은 새로운 데이터에서도 높은 예측 정확도를 유지하는 능력.
- 머신러닝 모델의 최종 목표이며, 검증 데이터/테스트 데이터 성능으로 평가.
- 관계 요약:
- Regularization: 일반화를 달성하기 위한 핵심 전략(모델 측면).
- Normalization/Standardization: 데이터를 안정적으로 학습시키기 위한 보조 전략(입력 측면)으로 일반화를 간접적으로 지원.
